

Engenharia Local em Manaus · análise
NVIDIA desafia arquitetura de CPUs para IA: foco em chip monolítico promete eliminar gargalo de desempenho
A NVIDIA afirma que a adoção de múltiplos chiplets em CPUs de servidores criou um gargalo crítico para cargas de IA agêntica. A empresa aposta em design monolítico para reduzir latência e aumentar a eficiência em data centers.
O avanço da inteligência artificial (IA) nos ambientes corporativos e de data center tem levado a indústria de hardware a repensar premissas que, até pouco tempo atrás, eram vistas como consenso. Uma dessas crenças é a de que aumentar a quantidade de núcleos em CPUs, por meio de arquiteturas baseadas em múltiplos chiplets, seria a melhor estratégia para escalar desempenho em servidores. No entanto, segundo reportagem do Canaltech, a NVIDIA considera que essa aposta generalizada trouxe uma falha estrutural relevante para cargas de trabalho de IA agêntica, especialmente aquelas que exigem raciocínio sequencial e respostas imediatas da CPU para acionar GPUs poderosas.
Essa análise, baseada em entrevista da equipe de engenharia da NVIDIA ao portal Wccftech, coloca em xeque a direção tomada por fabricantes tradicionais de processadores x86, que priorizaram a densidade de núcleos e a flexibilidade de design em detrimento da comunicação eficiente entre os núcleos de processamento. O resultado, segundo a NVIDIA, é um cenário em que a latência interna dos processadores se tornou o novo gargalo para operações de IA, com impacto direto em eficiência operacional e custo para empresas que dependem de data centers de alta performance.
O paradigma dos chiplets: promessa de escala, custo de latência
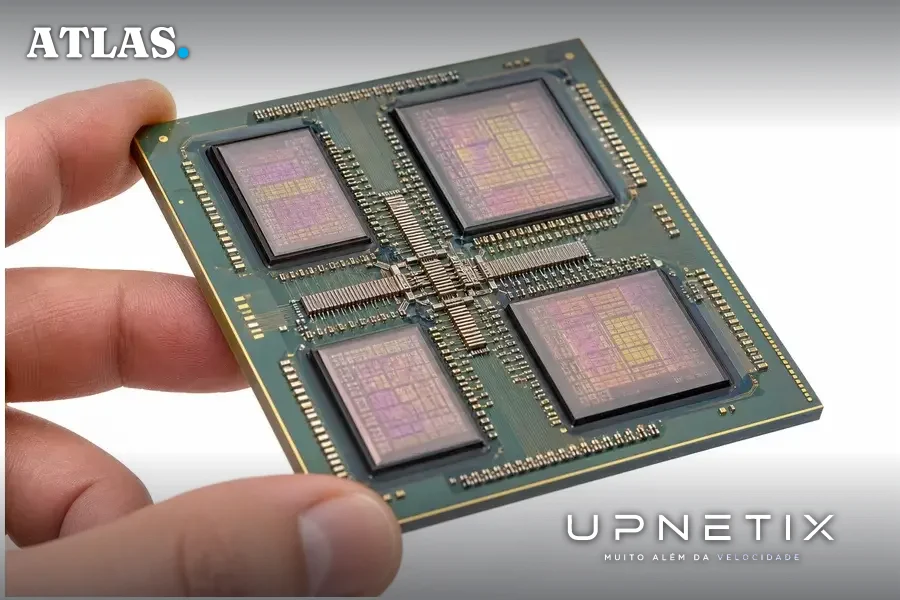
Nas últimas gerações de CPUs para servidores, a indústria priorizou a adoção de arquiteturas baseadas em chiplets, pequenas unidades de processamento conectadas dentro do mesmo encapsulamento. Essa abordagem permitiu aumentar o número de núcleos por processador, facilitando a fabricação e reduzindo custos de produção. No entanto, de acordo com o Canaltech, a NVIDIA aponta que essa decisão estratégica trouxe consequências negativas para cargas de trabalho que dependem de desempenho por núcleo e comunicação rápida entre eles.
Segundo a equipe da NVIDIA, em operações de IA agêntica, aquelas em que agentes autônomos executam loops contínuos de raciocínio em linguagens como Python, a CPU precisa responder rapidamente para acionar ferramentas e liberar a GPU para processamentos intensivos. O uso de chiplets, no entanto, impõe barreiras físicas de entrada e saída (I/O) dentro do próprio processador, elevando a latência e fazendo com que as GPUs fiquem ociosas aguardando instruções da CPU.
Esse cenário é especialmente preocupante para empresas que investiram pesado em clusters de GPUs de alto desempenho, esperando ganhos proporcionais em produtividade e eficiência. Quando o gargalo se desloca para a CPU, todo o investimento em aceleradores gráficos pode ser subaproveitado, aumentando o custo por tarefa processada e reduzindo o retorno sobre o investimento em infraestrutura.
NVIDIA Vera: design monolítico como resposta ao gargalo
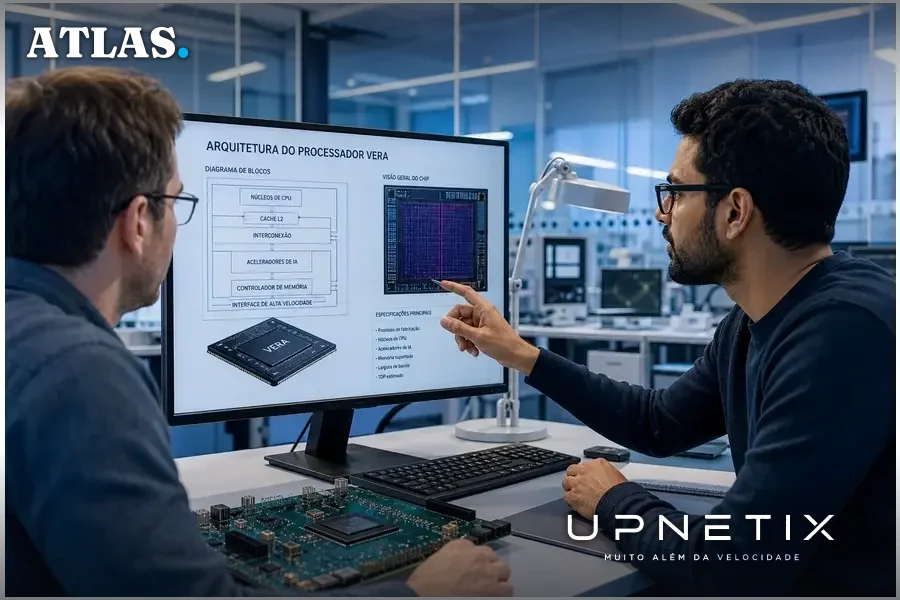
Em resposta a esse desafio, a NVIDIA adotou uma abordagem oposta ao projetar seu novo processador Vera, voltado exclusivamente para servidores e data centers de IA. Conforme detalhado pelo Canaltech, o Vera utiliza um único die monolítico, ou seja, todos os núcleos do processador estão integrados em uma única peça de silício, eliminando a necessidade de cruzar barramentos lentos de I/O entre chiplets.
De acordo com a NVIDIA, essa arquitetura permite uma largura de banda interna de 3,4 TB/s, o que representa até três vezes mais velocidade de compartilhamento de contexto entre núcleos em comparação com processadores concorrentes baseados em chiplets. O resultado, segundo a própria empresa, é um ganho de 1,5 vez em velocidade geral em relação à geração anterior (Grace) e o dobro de desempenho em cargas de trabalho de IA agêntica quando comparado aos principais processadores x86 do mercado.
A decisão de focar em um design monolítico foi possível, segundo a NVIDIA, porque o Vera foi concebido desde o início para aplicações em servidores e data centers, sem a necessidade de reaproveitar o projeto para o mercado consumidor. Isso permitiu otimizar cada aspecto do processador para as demandas específicas de IA, priorizando desempenho por núcleo e comunicação interna eficiente.
O que está em jogo para empresas: custo oculto da latência
A discussão sobre arquitetura de CPUs pode parecer técnica à primeira vista, mas suas implicações são diretas para empresas que dependem de processamento intensivo de dados, seja em setores industriais, financeiros, de saúde ou de governo. O principal risco apontado pela NVIDIA é que o gargalo de latência imposto pelos chiplets pode levar a um subaproveitamento significativo das GPUs, que representam um dos maiores custos de infraestrutura em data centers modernos.
Na prática, isso significa que organizações que investiram em clusters de IA podem estar pagando caro por capacidade computacional que permanece ociosa, simplesmente porque a CPU não consegue alimentar a GPU com dados na velocidade necessária. Essa ineficiência não apenas eleva o custo operacional, mas também pode limitar a capacidade de escalar aplicações de IA, atrasar projetos críticos e reduzir a competitividade em mercados que dependem de análise de dados em tempo real.
Além disso, a escolha da arquitetura de CPU impacta diretamente a previsibilidade e a estabilidade dos serviços oferecidos, fatores essenciais para empresas que operam em ambientes de missão crítica ou que precisam cumprir acordos de nível de serviço (SLAs) rigorosos. Latências imprevisíveis podem comprometer desde sistemas de automação industrial até plataformas de atendimento ao cliente baseadas em IA.
O contra-argumento: por que o mercado apostou nos chiplets?
Apesar da crítica da NVIDIA, a adoção de chiplets foi, por anos, vista como uma solução inovadora para superar limitações de escala e custo na fabricação de processadores. Fabricantes de CPUs x86, como Intel e AMD, argumentaram que a modularização permitia lançar produtos com maior número de núcleos, flexibilidade de configuração e melhor aproveitamento de silício, além de facilitar a atualização de componentes individuais sem redesenhar todo o processador.
Outro argumento recorrente é que, para muitas cargas de trabalho tradicionais, como bancos de dados, virtualização e aplicações web, o impacto da latência interna entre chiplets seria marginal diante dos ganhos em densidade e custo. Para esses casos, a escalabilidade proporcionada pelos chiplets compensaria eventuais perdas em desempenho por núcleo.
No entanto, a ascensão de cargas de IA agêntica, que exigem raciocínio sequencial e resposta imediata da CPU, mudou o perfil de demanda nos data centers. O que antes era uma otimização aceitável para workloads paralelizáveis agora se mostra um gargalo crítico em aplicações que não toleram atrasos entre CPU e GPU. A posição da NVIDIA, portanto, desafia o mercado a reavaliar se os benefícios dos chiplets ainda justificam o custo oculto da latência em cenários de IA avançada.
Incertezas e próximos passos: o que ainda não se sabe
Apesar das promessas da NVIDIA, ainda há pontos em aberto que o mercado observa com cautela. O Canaltech destaca que os ganhos de desempenho do Vera foram divulgados pela própria empresa, sem validação independente ou benchmarks públicos detalhados. Não está claro, por exemplo, como o processador se comporta em cargas de trabalho mistas, típicas de ambientes corporativos, nem se a abordagem monolítica trará desafios de fabricação e custo em larga escala.
Outro ponto de incerteza é se a estratégia da NVIDIA será adotada por outros fabricantes ou se permanecerá restrita a nichos de alto desempenho. Para empresas que já investiram em infraestrutura baseada em chiplets, a transição para uma arquitetura monolítica pode exigir mudanças profundas em planejamento de capacidade, integração de sistemas e até mesmo na escolha de fornecedores de nuvem e colocation.
Por fim, não há consenso sobre se a abordagem monolítica será viável para processadores de uso geral ou se permanecerá restrita a aplicações de IA de ponta. Como observa o Canaltech, “se isso vai ser refletido em processadores para o consumidor, aí é esperar para ver”.
O impacto para empresas de Manaus e o Polo Industrial: infraestrutura sob pressão
Para organizações instaladas em regiões como Manaus e o Polo Industrial, onde a disponibilidade e a qualidade da infraestrutura de conectividade são fatores críticos, a discussão sobre arquitetura de CPUs ganha contornos ainda mais relevantes. A latência adicional imposta por chiplets pode ser agravada por redes locais menos otimizadas, ampliando o risco de ociosidade de recursos e impactando diretamente a produtividade de operações industriais, logísticas e de serviços públicos que dependem de IA.
Empresas que buscam adotar ou expandir soluções de IA precisam considerar não apenas o investimento em hardware, mas também a capacidade de suas redes internas e externas de suportar a comunicação eficiente entre CPU e GPU. A escolha de parceiros de conectividade que ofereçam baixa latência, alta disponibilidade e suporte técnico local torna-se um diferencial competitivo para garantir que o potencial dos novos processadores seja plenamente realizado.
Em um cenário em que a eficiência operacional depende cada vez mais da integração entre hardware de ponta e infraestrutura de rede robusta, decisões equivocadas sobre arquitetura de servidores podem gerar custos invisíveis e comprometer o desempenho de toda a cadeia produtiva.
A aposta da NVIDIA em design monolítico para CPUs de IA lança um alerta para empresas que, até agora, confiaram na escalabilidade dos chiplets como solução definitiva. O debate sobre latência interna e desempenho por núcleo deixa claro que, na era da IA agêntica, não basta investir em GPUs potentes: a infraestrutura de processamento e conectividade precisa ser repensada como um todo, especialmente em polos industriais como Manaus, onde cada milissegundo pode representar ganhos ou perdas reais na operação.
Conteúdo B2B sobre conectividade, infraestrutura digital e gestão de TI, direto na caixa de entrada, sem spam.
Latência interna pode anular seu investimento em IA. Se a CPU não acompanha a GPU, a rede vira gargalo e o custo explode. O IP Premium Dedicado da Upnetix entrega link empresarial de fibra dedicada, SLA garantido em contrato e latência estável para conectar data centers e aplicações de IA. Avaliamos a viabilidade técnica no seu endereço antes de qualquer proposta. Nossa equipe entra em contato em até 1 dia útil com uma proposta sob medida.Fale com um especialista da Upnetix
O Atlas é o portal editorial da Upnetix. Conteúdo informativo, apurado em fontes públicas com apoio de inteligência artificial sob supervisão editorial; não constitui aconselhamento técnico, jurídico ou financeiro. Termos de uso e política editorial. Correções e direito de resposta: comercial@upnetix.com.br.
