
Inovação · análise
Falhas em data centers expõem limites da redundância e forçam mudança estratégica na gestão de infraestrutura crítica
Interrupções recentes em data centers globais, como as da AWS, revelam que apenas ampliar capacidade não garante continuidade. Empresas agora precisam integrar energia, climatização e monitoramento para antecipar falhas e mitigar prejuízos milionários.
Durante anos, o mantra da infraestrutura crítica era simples: investir em redundância e resposta rápida bastava para garantir a continuidade dos negócios. No entanto, as falhas recentes em grandes data centers, como os da Amazon Web Services (AWS), desafiaram essa crença confortável, mostrando que a complexidade atual exige uma abordagem muito mais estratégica. Para quem decide em empresas ou órgãos públicos, a lição é clara: confiar apenas em capacidade computacional e planos de contingência já não protege contra perdas operacionais e financeiras de grande escala.
Falhas recentes colocam em xeque o modelo tradicional
O início de 2026 foi marcado por uma interrupção significativa nos serviços da AWS, causada por um evento térmico em um de seus principais data centers no norte da Virgínia, nos Estados Unidos. Segundo o TI Inside, o incidente levou à perda de energia e à indisponibilidade parcial de serviços amplamente utilizados por empresas em todo o mundo. Embora a recuperação tenha levado apenas algumas horas, o impacto foi global. E não foi um caso isolado: em outubro do ano anterior, outro apagão envolvendo a AWS resultou, de acordo com a Reuters, na maior interrupção de serviços de internet desde a falha da CrowdStrike em 2024, que afetou aeroportos, hospitais e instituições financeiras em diversos países.
Esses episódios evidenciam um ponto de consenso entre especialistas: a infraestrutura digital tornou-se o pilar da continuidade dos negócios, mas sua resiliência está cada vez mais pressionada pelo crescimento da inteligência artificial (IA) e pela demanda por computação de alta performance. O TI Inside destaca que, à medida que empresas aceleram investimentos em IA, cresce também a exigência de manter ativos físicos operando sem falhas, uma tarefa que vai além do simples aumento de capacidade.
Escalada de consumo e riscos financeiros crescentes
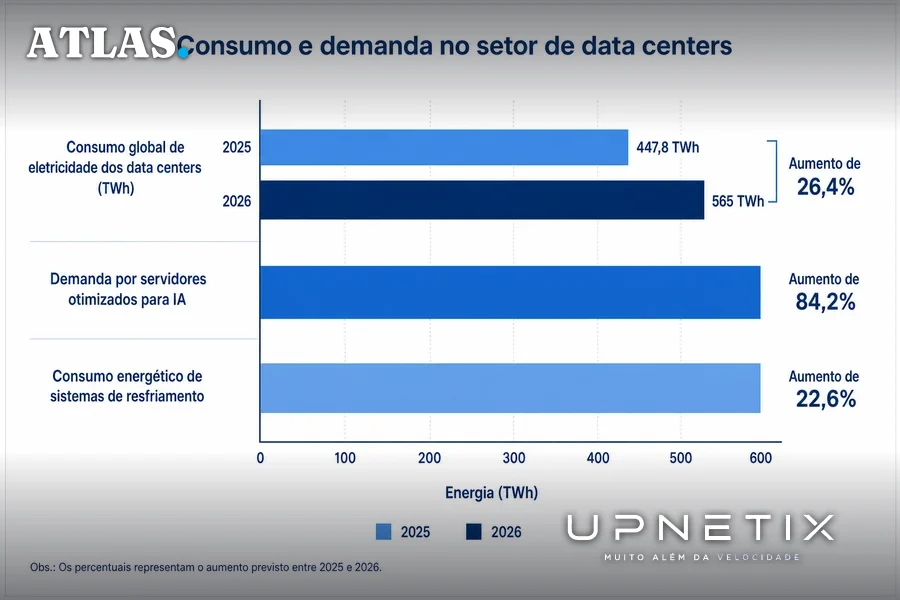
O cenário de expansão da IA traz consigo uma explosão no consumo de energia e na complexidade operacional dos data centers. Projeções do Gartner, citadas pelo TI Inside, apontam que o consumo global de eletricidade dos data centers deve atingir 565 terawatts-hora (TWh) em 2026, um aumento de 26,4% em relação a 2025. A demanda por servidores otimizados para IA cresceu 84,2%, enquanto o consumo energético de sistemas de resfriamento e infraestrutura de suporte subiu 22,6%.
Esses números não são apenas estatísticas: eles se traduzem em riscos financeiros concretos. Segundo a edição 2026 do Annual Data Center Survey do Uptime Institute, 57% dos gestores de data centers relataram que a última grande interrupção em seus ambientes gerou prejuízos superiores a US$ 100 mil. Em um em cada cinco casos, as perdas ultrapassaram US$ 1 milhão. Além disso, metade dos operadores reportou pelo menos uma interrupção relevante nos últimos três anos, sendo falhas de climatização a segunda principal causa de indisponibilidade.
Gestão estratégica: do silo ao ecossistema integrado
O consenso entre especialistas, como Luis Cuevas, diretor de Secure Power e Cloud & Service Provider da Schneider Electric no Brasil, é que a abordagem tradicional baseada em redundância e resposta rápida está sendo substituída por modelos orientados por dados, capazes de antecipar anomalias antes que se transformem em falhas. Cuevas afirma que “a inteligência artificial mudou o eixo da discussão”, e que o desempenho operacional agora depende de uma infraestrutura capaz de integrar energia, distribuição elétrica, climatização, monitoramento e software.
Essa mudança implica abandonar a gestão em silos e adotar uma arquitetura operacional unificada, onde equipamentos elétricos, sistemas de climatização, UPSs (Uninterruptible Power Supply) e plataformas de automação são monitorados em tempo real. Essa visibilidade permite correlacionar informações, diagnosticar desvios de rendimento e reduzir riscos de queda, tornando possível agir preventivamente. “Não dependemos mais apenas da redundância para assegurar a continuidade”, diz Cuevas, destacando que a antecipação de falhas é fundamental diante da crescente complexidade dos ambientes críticos.
Contra-argumentos: redundância ainda tem papel?
Apesar da tendência de integração e automação, há quem defenda que a redundância física ainda é indispensável, especialmente em operações onde o risco de falha não pode ser tolerado. No entanto, os dados do Uptime Institute e os exemplos recentes de falhas na AWS mostram que, mesmo com múltiplos sistemas redundantes, eventos inesperados, como falhas térmicas ou de climatização, podem escapar ao controle e causar interrupções de grande impacto.
A discussão, portanto, não é sobre abandonar a redundância, mas sobre reconhecer seus limites. O TI Inside aponta que a integração de monitoramento contínuo, automação e análise preditiva oferece uma camada adicional de proteção, capaz de identificar sinais de degradação com antecedência suficiente para evitar prejuízos milionários. O consenso é que, diante da escalada de densidade computacional e consumo energético, confiar apenas em redundância é subestimar o risco real.
O que ainda não se sabe e os desafios para empresas brasileiras
Apesar dos avanços em monitoramento e automação, persistem incertezas importantes. Não há consenso sobre o grau de maturidade dessas soluções em mercados emergentes ou sobre o custo-benefício de sua implementação em operações de menor escala. O TI Inside destaca exemplos de grandes investimentos, como o projeto de US$ 290 milhões da Schneider Electric para o campus Lake Mariner, nos EUA, mas não há dados consolidados sobre a adoção dessas práticas no Brasil ou na região Norte.
Para empresas localizadas fora dos grandes centros, como Manaus, o desafio é ainda maior. A dependência de conectividade estável e de infraestrutura crítica confiável torna a antecipação de falhas e a integração operacional não apenas desejáveis, mas essenciais para evitar impactos financeiros e reputacionais. No entanto, a falta de dados sobre a maturidade dessas soluções no contexto brasileiro exige cautela e análise criteriosa antes de investir.
Implicações para a decisão empresarial: o que muda na prática
Para gestores de TI, compradores corporativos e responsáveis por operações críticas, a principal consequência desse novo cenário é a necessidade de repensar a gestão da infraestrutura digital. Não basta mais contratar capacidade computacional ou garantir redundância física. É preciso investir em monitoramento contínuo, automação e análises preditivas que permitam antecipar falhas e equilibrar disponibilidade, eficiência energética e sustentabilidade.
Empresas que operam no Polo Industrial de Manaus ou em setores onde a interrupção de serviços pode gerar perdas milionárias não podem mais tratar a infraestrutura como um elemento invisível. A integração de energia, climatização e software de gestão passa a ser um diferencial competitivo, reduzindo riscos e fortalecendo a resiliência operacional. A decisão de compra deve considerar não apenas o preço, mas a capacidade do fornecedor de entregar visibilidade, suporte local e integração de sistemas críticos.
O avanço da IA e a crescente dependência de conectividade estável tornam inevitável a evolução da gestão de infraestrutura crítica. Para quem decide, o desafio está em equilibrar investimento, risco e disponibilidade, sabendo que a próxima falha pode custar muito mais do que o previsto. O futuro da operação depende menos de planos de contingência e mais da capacidade de antecipar e mitigar ameaças antes que se tornem crises.
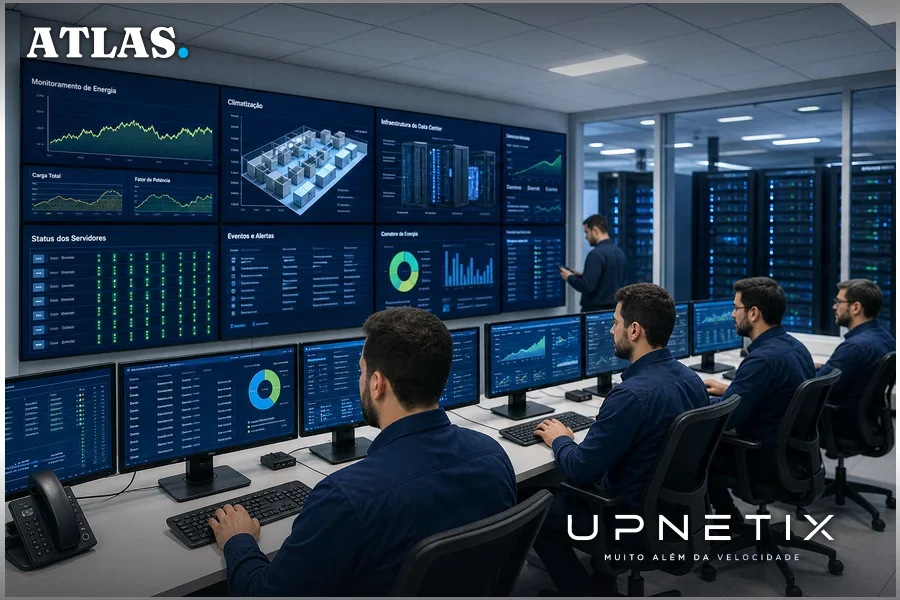
Os recentes episódios de indisponibilidade em data centers globais mostraram que confiar apenas em redundância é subestimar a complexidade dos riscos atuais. Empresas que conseguem integrar monitoramento, automação e análise preditiva à sua infraestrutura estarão mais preparadas para evitar prejuízos milionários e manter a continuidade em um cenário de pressão crescente por desempenho e disponibilidade.
Conteúdo B2B sobre conectividade, infraestrutura digital e gestão de TI, direto na caixa de entrada, sem spam.
Redundância não basta quando a falha é imprevisível. Instabilidade em data centers pode custar caro para quem depende de operação contínua. O IP Premium Dedicado da Upnetix oferece link empresarial de fibra dedicada, SLA garantido em contrato e suporte humano local. Avaliamos a viabilidade técnica no seu endereço antes de qualquer proposta. Nossa equipe entra em contato com uma proposta sob medida.Fale com um especialista da Upnetix
O Atlas é o portal editorial da Upnetix. Conteúdo informativo, apurado em fontes públicas com apoio de inteligência artificial sob supervisão editorial; não constitui aconselhamento técnico, jurídico ou financeiro. Política editorial e termos de uso. Correções e direito de resposta: comercial@upnetix.com.br.
